
Создание кластера K8s
ВВЕДЕНИЕ
Managed Kubernetes в DevSpace — это полноценный кластер Kubernetes, который разворачивается в вашем пространстве за несколько минут и обслуживается платформой. В отличие от установки на собственных VM или bare-metal-серверах, вам не нужно готовить операционную систему, устанавливать компоненты кластера, настраивать сеть между узлами и следить за управляющим слоем — всё это берёт на себя DevSpace.
Управляющие компоненты кластера (API-сервер, планировщик и другие) работают внутри платформы и не занимают ваши рабочие узлы. Рабочие узлы — это виртуальные машины, которые создаются и удаляются автоматически в заданных вами пределах. Вы получаете адрес кластера, файл доступа (kubeconfig) и работаете с кластером так же, как с любым другим Kubernetes: через kubectl, GitOps-инструменты или графические клиенты.
ПЕРЕД НАЧАЛОМ
У вас уже должно быть создано пространство в сервисе DevSpace и настроен доступ к его к его приложениям (сервисам). Все действия ниже выполняются внутри вашего пространства.
Также понадобится компьютер с доступом в интернет, на который вы установите утилиту kubectl для управления кластером.
Пошаговое руководство
Руководство описывает только то, что нужно заполнить, чтобы получить рабочий кластер. Остальные поля формы можно оставить по умолчанию — их разбор есть в разделе «Параметры».
Шаг 1. Откройте форму создания кластера
В дашборде откройте Marketplace, выберите категорию Infrastructure и карточку Kubernetes. То же самое делает меню в левом верхнем углу консоли: выберите Kubernetes и нажмите Deploy. У формы две вкладки — Form с полями и YAML с той же конфигурацией текстом.
Шаг 2. Задайте имя и основные параметры
|
Поле
|
Значение в примере
|
Зачем
|
|
Name
|
demo
|
Имя кластера: строчные латинские буквы и цифры. Войдёт в адрес API
|
|
storageClass
|
replicated
|
Класс хранилища для томов приложений внутри кластера. После создания изменить нельзя
|
|
version
|
оставьте по умолчанию
|
Версия Kubernetes. По умолчанию предлагается самая свежая из доступных
|
|
host
|
оставьте пустым
|
Своё внешнее имя для API. Пустое поле означает адрес по умолчанию
|
Дальше в статье <name> — это имя, которое вы задали в поле Name: платформа подставляет его в имена сервисов, секретов и компонентов инстанса.
Имя попадает в адрес API: кластер demo в пространстве a7f3k9m2q5 получит адрес kubernetes-demo.a7f3k9m2q5.devspace.oblakoteka.ru. По этому адресу API доступен из интернета сразу после создания — он публикуется через входной шлюз платформы, а защищён сертификатами из файла доступа: без него подключиться нельзя.
storageClass задаёт, в каком классе хранилища платформы будут создаваться постоянные тома (PVC) ваших приложений. Выбор зависит от того, реплицирует ли приложение свои данные само: кластерным базам и брокерам сообщений подходит local — он быстрее, а копии данных у них и так есть на других экземплярах (репликах). Всему остальному оставляйте replicated, иначе отказ одного сервера хранения означает потерю тома.
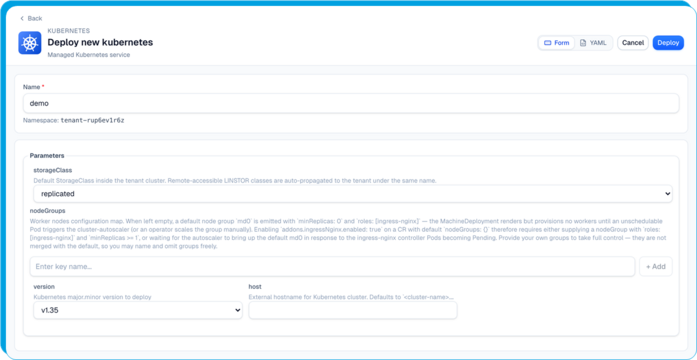
Шаг 3. Добавьте группу рабочих узлов
Рабочие узлы — это виртуальные машины, объединённые в группы. Группы задаются как список с именами, и в пустой форме ни одной группы нет: впишите имя группы, например md0, в поле Enter key name… и нажмите рядом + Add. Группа раскроется отдельным блоком с полями.
Заполните в этом блоке четыре поля:
|
Поле
|
Значение в примере
|
Зачем
|
|
minReplicas / maxReplicas
|
2 и 2
|
Границы автоматического масштабирования. Одинаковые значения дают фиксированный размер группы, разные — кластер сам добавляет и убирает узлы по нагрузке, не выходя за эти границы
|
|
instanceType
|
u1.medium
| |
|
diskSize
|
20Gi
|
Системный диск узла: образы контейнеров, логи, временные данные. При пересоздании узла его содержимое теряется, данные приложений живут не здесь
|
|
roles
|
ingress-nginx
|
Роль узлов. Нажмите + add и впишите значение. Без неё не заработает аддон Ingress-NGINX из шага 4
|
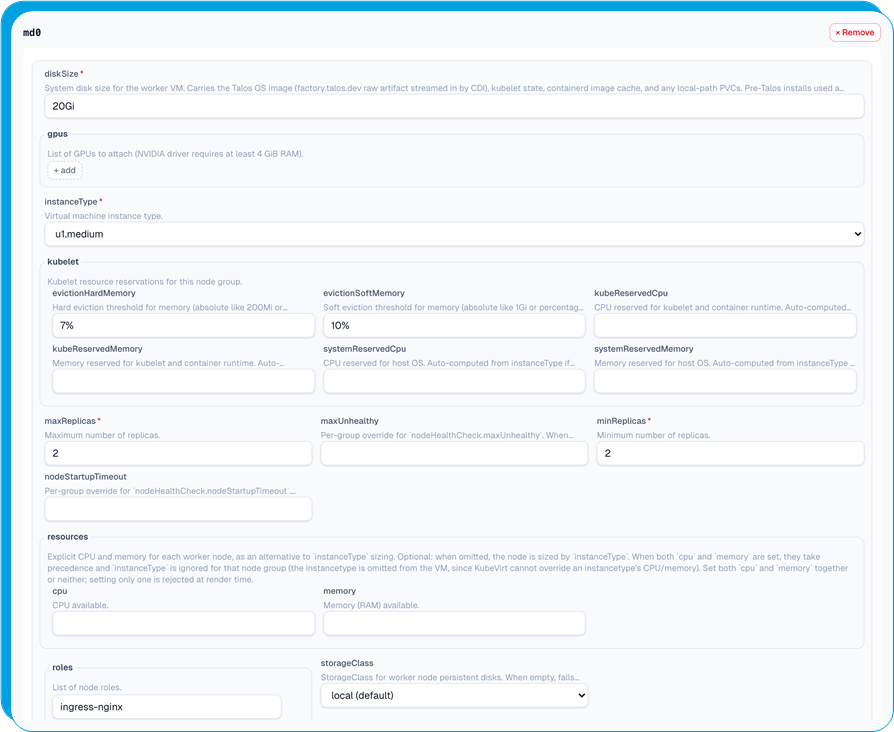
Остальные поля группы — kubelet, resources, gpus, maxUnhealthy, nodeStartupTimeout — оставьте как есть. А вот на storageClass в этом же блоке стоит посмотреть отдельно.
Подсказка: в форме два поля storageClass, и это разные вещи. Верхнее, из шага 2, — класс хранилища для томов ваших приложений внутри кластера. Поле внутри группы узлов — класс для системных дисков самих виртуальных машин-узлов, и форма подставляет в него local (default).
Разница на практике в переносе узлов. С replicated диск узла доступен сразу с нескольких серверов платформы, и работающий узел может переехать между ними без остановки — например, когда сервер уводят на обслуживание. С local узел привязан к своему серверу: вместо переезда его пересоздадут (что немного дольше), а приложения переедут на другие узлы силами самого Kubernetes. Для большинства кластеров local подходит, менять его стоит осознанно.
|
Шаг 4. Включите нужные аддоны
Аддоны — готовые компоненты, которые платформа ставит в кластер вместе с его созданием. Для публикации веб-приложений включите два:
-
certManager → enabled — автоматический выпуск и продление TLS-сертификатов
-
ingressNginx → enabled — контроллер входящего HTTP/HTTPS-трафика. Поле exposeMethod оставьте Proxied, список hosts можно заполнить позже.
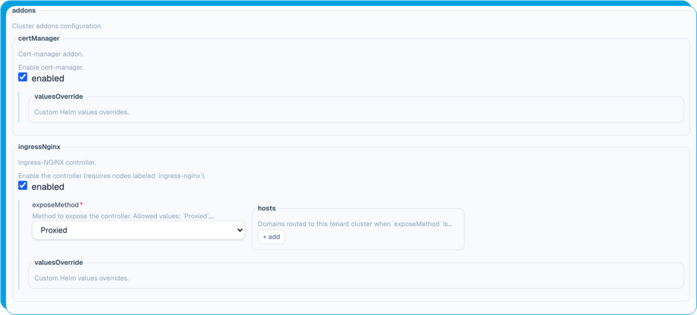
Остальные аддоны для первого кластера оставьте выключенными. Что умеет каждый и когда его включать — в разделе «Параметры», там же разобраны способы публикации приложений.
Всё, что выключено сейчас, можно включить позже, изменив конфигурацию кластера.
Шаг 5. Укажите источник образов узлов и создайте кластер
В группе полей talos замените imageFactoryURL на адрес зеркала Облакотеки:
https://fs.oblakoteka.ru/talos
|
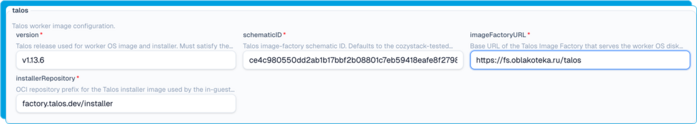
По умолчанию в поле указан публичный репозиторий образов Talos, из публичных сетей РФ он доступен нестабильно. Без образа виртуальные машины узлов не создадутся, поэтому адрес зеркала обязателен. Пишется без косой черты на конце, остальные поля группы talos не трогайте.
Группы полей controlPlane, nodeHealthCheck, oidc и images оставьте по умолчанию — для рабочего кластера их менять не нужно. Нажмите Deploy.
Шаг 6. Дождитесь готовности кластера
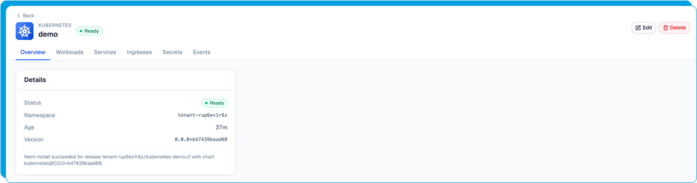
Создание занимает несколько минут. Статус Ready в шапке карточки означает, что платформа применила конфигурацию.
Фактическое состояние показывает вкладка Workloads: там перечислены компоненты управляющего слоя и виртуальные машины узлов. Строки virt-launcher-… — это и есть ваши рабочие узлы.
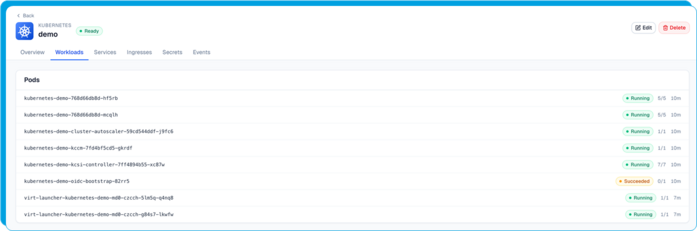
Готовность — когда в строках стоит Running, а числа в счётчике равны: 1/1, 5/5, 7/7. Одна строка выбивается из этого правила: разовая задача oidc-bootstrap заканчивается статусом Succeeded со счётчиком 0/1, и это нормально — задача отработала и завершилась. Если что-то долго не запускается, загляните на вкладку Events.
Шаг 7. Заберите файл доступа
На вкладке Secrets карточки кластера лежит секрет kubernetes-<name>-admin-kubeconfig с четырьмя ключами:
-
admin.conf— тот, что вам нужен: файл kubeconfig с внешним адресом кластера, для подключения со своего компьютера
-
admin.svc— тот же доступ, но с внутренним адресом: для сервисов внутри платформы
-
super-admin.confи super-admin.svc — аварийный доступ с максимальными правами в обход обычной модели прав, для повседневной работы не нужен
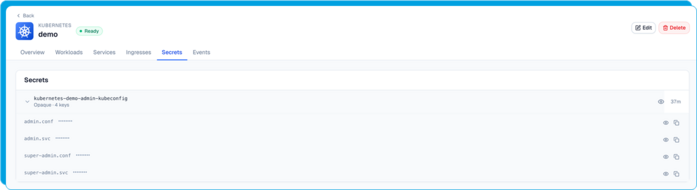
Подсказка: не выделяйте содержимое секрета мышкой — так легко захватить лишние символы или потерять переносы строк. Рядом с каждым ключом есть кнопка копирования, она копирует значение в точности.
|
Шаг 8. Установите kubectl и подключитесь к кластеру
kubectl — стандартная консольная утилита для управления Kubernetes. Установите её по официальной инструкции для вашей операционной системы. Желательно ставить версию, соответствующую версии вашего кластера (например, kubectl 1.35 для кластера v1.35) — допустимо отклонение в один минорный релиз.
Затем сохраните kubeconfig:
mkdir -p ~/.kube
# если у вас уже есть файл ~/.kube/config от другого кластера — сначала сохраните его копию:
cp ~/.kube/config ~/.kube/config.backup
# откройте файл в редакторе и вставьте содержимое ключа admin.conf, скопированное кнопкой копирования:
nano ~/.kube/config
|
После вставки убедитесь, что форматирование не сломалось: файл должен выглядеть как аккуратный YAML с отступами, без «слипшихся» строк. Проверьте подключение:
kubectl get nodes
|
Шаг 9. Дождитесь готовности узлов
Готовый кластер — это ещё не готовые к работе узлы и поды в нём. Сразу после создания рабочие узлы могут ещё регистрироваться в кластере, а системные компоненты — запускаться. Порядок такой: сначала стартует сеть кластера (в DevSpace по умолчанию используется Cilium), после неё узлы переходят в состояние Ready, затем поднимаются остальные системные компоненты и включённые аддоны (cert-manager, Ingress-NGINX и другие).
Подождите несколько минут и проверьте:
kubectl get nodes
|
kubectl get pods -A
|
Когда все узлы в состоянии Ready, а системные поды — Running, кластер готов к работе. Единичные перезапуски системных подов на этапе старта — это нормально: компоненты ждут друг друга.
Шаг 10 (по желанию). Установите Freelens — графический обозреватель кластера
Freelens — бесплатное десктопное приложение с открытым исходным кодом, своеобразный «проводник» по Kubernetes. Оно особенно полезно на первых порах: позволяет изучать кластер визуально, не заучивая команды kubectl.
Где взять: скачайте установщик для Windows, macOS или Linux с freelens.app или со страницы релизов на GitHub.
Как подключить кластер: Freelens работает с теми же kubeconfig-файлами, что и kubectl. Можно добавить файл конфигурации вручную через меню добавления кластера, а можно настроить автоматическое подхватывание конфигов из нужной директории (например, ~/.kube) — тогда кластер появится в списке сам.
Что в нём удобно смотреть:
-
Nodes — состояние и ресурсы узлов кластера
-
Workloads → Pods — запущенные поды. Отсюда же можно посмотреть логи пода или удалить его для перезапуска
-
Namespaces — пространства имён. Здесь же создаются новые
-
Config → Secrets / ConfigMaps — секреты и конфигурации с фильтрацией по пространствам имён
-
Storage → Storage Classes — доступные классы хранения. Пригодятся при написании манифестов с постоянными томами
-
Network — сервисы, endpoints и ingress-ресурсы
Функциональность расширяется плагинами: например, плагин для Flux CD показывает состояние GitOps-объектов прямо в интерфейсе.
ПАРАМЕТРЫ
Полный список параметров кластера. Всё, что не задано явно, платформа заполняет значениями по умолчанию из этой таблицы.
Основные
|
Параметр
|
Что делает
|
Значение по умолчанию
|
Когда менять
|
|
version
|
Версия Kubernetes (major.minor). В списке — несколько последних версий, платформа разворачивает последний патч-релиз выбранной.
|
самая свежая из списка
|
При переносе нагрузок с существующего кластера — выбрать его версию.
|
|
host
|
Внешнее DNS-имя кластера, по которому доступен его API.
|
пусто = kubernetes-.<домен-пространства>
|
Если хотите использовать собственный домен.
|
|
storageClass
|
Класс хранения для постоянных томов (PVC) приложений в кластере: replicated — данные тома дублируются хранилищем на нескольких серверах. local — без репликации на уровне хранилища, быстрее. Объём томов тарифицируется по ресурсу «Хранилище». Нельзя изменить после создания.
|
replicated
|
local — для приложений, которые сами реплицируют свои данные между своими экземплярами (кластерные БД, брокеры сообщений). Приложению в одном экземпляре оставляйте replicated: копии данных больше нигде нет. У replicated ввод-вывод медленнее.
|
Управляющий слой (control plane)
Управляющий слой работает на стороне платформы, и для рабочего кластера эту группу полей менять не нужно — всё, что ниже, имеет разумные значения по умолчанию. Единственное, что стоит выбрать осознанно, — controlPlane.replicas: две реплики переживают отказ, одна экономит ресурсы на тестовом кластере.
Ресурсы каждого компонента задаются либо именованным пресетом (resourcesPreset), либо явными значениями CPU и памяти (resources) — явные значения имеют приоритет. Справочник по пресетам ресурсов.
|
Параметр
|
Что делает
|
Значение по умолчанию
|
Когда менять
|
|
controlPlane.replicas
|
Число реплик управляющего слоя.
|
2
|
1 — для экономии на тестовых кластерах. 2+ — отказоустойчивость для production.
|
|
controlPlane.apiServer.resourcesPreset
|
c1.medium
|
При росте кластера и числа обращений к API.
| |
|
controlPlane.apiServer.resources
|
Явные CPU/память API-сервера (переопределяют пресет).
|
не заданы
|
Когда пресетов недостаточно и нужны точные значения. Память указывайте с единицами измерения: 512Mi, 2Gi.
|
|
controlPlane.controllerManager.resourcesPreset
|
Пресет ресурсов controller manager.
|
t1.micro
|
Редко. При большом числе объектов в кластере.
|
|
controlPlane.controllerManager.resources
|
Явные CPU/память controller manager.
|
не заданы
|
Аналогично. Память указывайте с единицами измерения: 512Mi, 2Gi.
|
|
controlPlane.scheduler.resourcesPreset
|
Пресет ресурсов планировщика.
|
t1.micro
|
Редко.
|
|
controlPlane.scheduler.resources
|
Явные CPU/память планировщика.
|
не заданы
|
Редко. Память указывайте с единицами измерения: 512Mi, 2Gi.
|
|
controlPlane.konnectivity.server.resourcesPreset
|
Пресет ресурсов konnectivity-сервера (туннель между управляющим слоем и узлами).
|
t1.micro
|
Редко.
|
|
controlPlane.konnectivity.server.resources
|
Явные CPU/память konnectivity-сервера.
|
не заданы
|
Редко. Память указывайте с единицами измерения: 512Mi, 2Gi.
|
Группы рабочих узлов (nodeGroups)
Узлы объединяются в именованные группы. По умолчанию создаётся одна группа md0. Групп может быть несколько — например, отдельная группа более крупных узлов под ресурсоёмкие сервисы. Все параметры ниже задаются для каждой группы.
|
Параметр
|
Что делает
|
Значение по умолчанию
|
Когда менять
|
|
minReplicas
|
Минимальное число узлов в группе — нижняя граница автомасштабирования.
|
0
|
Задайте не меньше числа узлов, которое должно работать всегда.
|
|
maxReplicas
|
Максимальное число узлов — верхняя граница автомасштабирования.
|
10
|
По потолку бюджета и ожидаемой нагрузке.
|
|
instanceType
|
Тип виртуальной машины узла (CPU и память), например u1.medium. Справочник по типам.
|
u1.medium
|
Под требования ваших приложений.
|
|
diskSize
|
Размер временного (ephemeral) диска узла: образы контейнеров, логи, временные данные подов, данные kubelet и containerd. Содержимое теряется при пересоздании узла. Постоянные тома приложений сюда не входят — они выделяются из хранилища платформы (см. storageClass кластера).
|
20Gi
|
Если приложения используют много крупных образов или активно пишут во временные тома.
|
|
storageClass
|
Класс хранения для дисков самих виртуальных машин узлов. Не путайте с storageClass кластера: тот отвечает за тома приложений.
|
local (default) — подставляет форма
|
replicated — чтобы работающий узел мог переезжать между серверами платформы без пересоздания: его диск должен быть доступен сразу с нескольких серверов.
|
|
roles
|
Список ролей узлов группы. Роль ingress-nginx требуется хотя бы у одной группы, чтобы работал одноимённый аддон.
|
[] у группы, созданной вручную. ["ingress-nginx"] у служебной группы md0
|
Добавьте ingress-nginx своей группе, если планируете включать и использовать одноимённый аддон (см. раздел Аддоны)
|
|
resources
|
Явные CPU/память узла (вместо instanceType).
|
не заданы
|
Когда типовые размеры не подходят. Память указывайте с единицами измерения: 512Mi, 2Gi.
|
|
gpus
|
Список GPU, подключаемых к узлам группы, — для вычислительных и ML-нагрузок.
|
[]
|
Пока не используется: узлов с GPU в DevSpace нет.
|
|
kubelet.evictionHardMemory
|
Жёсткий порог памяти, при котором узел начинает вытеснять поды (абсолютное значение или процент).
|
7%
|
Тонкая настройка стабильности узлов.
|
|
kubelet.evictionSoftMemory
|
Мягкий порог вытеснения по памяти.
|
10%
|
Аналогично.
|
|
kubelet.systemReservedMemory / kubelet.systemReservedCpu
|
Память/CPU, зарезервированные для ОС узла.
|
пусто = вычисляются из instanceType
|
Обычно не требуется.
|
|
kubelet.kubeReservedMemory / kubelet.kubeReservedCpu
|
Память/CPU, зарезервированные для kubelet и контейнерного рантайма.
|
пусто = вычисляются из instanceType
|
Обычно не требуется.
|
Аддоны (addons)
У каждого аддона есть поле valuesOverride — расширенная настройка компонента для опытных пользователей. По умолчанию оно пустое - компонент работает с настройками платформы по умолчанию.
|
Параметр
|
Что делает
|
Значение по умолчанию
|
Когда менять
|
|
certManager.enabled
|
Автоматический выпуск и продление TLS-сертификатов (включая Let’s Encrypt).
|
false
|
Включите вместе с Ingress-NGINX для публикации приложений по HTTPS.
|
|
ingressNginx.enabled
|
Контроллер входящего HTTP/HTTPS-трафика. Требует роли ingress-nginx на узлах (есть по умолчанию).
|
false
|
Включите для публикации веб-приложений.
|
|
ingressNginx.exposeMethod
|
Способ публикации контроллера: Proxied — через входной шлюз платформы (без выделенного IP, только домены из hosts), LoadBalancer — через выделенный балансировщик с собственным внешним IP (список hosts не используется, DNS-записи ваших приложений направляются на этот IP. Внешний IP тарифицируется отдельно).
|
Proxied
|
LoadBalancer — когда нужен отдельный внешний IP и трафик в обход общего шлюза.
|
|
ingressNginx.hosts
|
Полные доменные имена, трафик которых входной шлюз платформы направляет в этот кластер (при exposeMethod: Proxied). Записываются как есть, без автоматического дополнения. Поддомены домена пространства работают без настройки DNS. Для собственных доменов настройте CNAME на домен пространства. Wildcard-имена (*.apps.example.com) допустимы, но HTTPS для них терминируется на шлюзе платформы с его сертификатом — для полноценного TLS с собственными сертификатами перечисляйте имена явно. Список открывает домену путь только до кластера. Маршрут до приложения задаёт Ingress-ресурс внутри кластера.
|
[]
|
Обязательно заполните при публикации приложений через Proxied. Можно дополнять после создания кластера.
|
|
fluxcd.enabled
|
GitOps-оператор Flux CD: применяет манифесты из Git-репозитория.
|
false
|
Включите для GitOps-подхода. Не включайте при использовании Argo CD.
|
|
velero.enabled
|
Резервное копирование и восстановление объектов кластера в S3.
|
false
|
Рекомендуется для любых важных сред.
|
|
gatewayAPI.enabled
|
Поддержка Gateway API — современной альтернативы Ingress для маршрутизации трафика.
|
false
|
Если ваши приложения используют Gateway API.
|
|
gpuOperator.enabled
|
NVIDIA GPU Operator: драйверы и обвязка для работы с GPU на узлах.
|
false
|
Пока не используется: узлов с GPU в DevSpace нет.
|
|
hami.enabled
|
HAMi — виртуализация GPU (разделение одной карты между подами). Требует включённого GPU Operator.
|
false
|
Пока не используется: узлов с GPU в DevSpace нет.
|
|
monitoringAgents.enabled
|
Агенты мониторинга (сбор метрик и логов) с отправкой в систему мониторинга пространства (заказывается через заявку в поддержку)
|
false
|
Рекомендуется для production.
|
|
ouroboros.enabled
|
Исправление hairpin-NAT для Ingress-NGINX с PROXY-протоколом. Требует включённого ingressNginx. Полезен только при настроенном PROXY-протоколе.
|
false
|
Узкий случай. Включайте по рекомендации поддержки.
|
|
cilium.valuesOverride
|
Тонкая настройка сети кластера (Cilium — сеть по умолчанию, отключить её нельзя).
|
{}
|
Только для опытных пользователей.
|
|
coredns.valuesOverride
|
Тонкая настройка DNS кластера (CoreDNS устанавливается всегда).
|
{}
|
Только для опытных пользователей.
|
|
verticalPodAutoscaler.
valuesOverride |
Тонкая настройка Vertical Pod Autoscaler.
|
{}
|
Только для опытных пользователей.
|
Публикация веб-приложений подробнее
Приложения, запущенные в кластере, по умолчанию не доступны из интернета. Способ публикации выбирается под задачу:
-
сайты, веб-приложения, HTTP-API — связка cert-manager и Ingress-NGINX: все веб-приложения кластера публикуются через один вход, с маршрутизацией по доменам и автоматическими сертификатами. Если приложения построены на Gateway API, вместо Ingress-NGINX включите одноимённый аддон
-
не-веб-сервис — база данных, брокер сообщений, игровой сервер, что угодно с произвольным TCP- или UDP-протоколом — аддоны не нужны: создайте для приложения сервис типа LoadBalancer внутри кластера. Приложение получит собственный внешний адрес, трафик пойдёт напрямую в него. Каждый такой адрес тарифицируется отдельно
У Ingress-NGINX два способа публикации самого контроллера:
-
Proxied (по умолчанию) — трафик приходит через общий входной шлюз платформы, отдельный внешний адрес не выделяется. Перечислите в поле hosts полные доменные имена ваших приложений — они записываются как есть, без автоматического дополнения домена. Пока список пуст, внешний трафик в кластер не маршрутизируется. Поддомен вашего пространства (app.<домен-пространства>) уже указывает на шлюз платформы и работает сразу. Для собственного домена создайте у своего DNS-провайдера CNAME на домен пространства, а для корневого домена, где CNAME недопустим, — A-запись на адрес шлюза
-
LoadBalancer — контроллер получает выделенный балансировщик с собственным внешним адресом, на него вы направляете DNS-записи своих доменов, и трафик идёт в кластер напрямую. Список hosts при этом не используется. Это по-прежнему один вход для всех веб-приложений кластера — не путайте с сервисом LoadBalancer для отдельного приложения
При способе Proxied список hosts лишь открывает домену дорогу от шлюза платформы до вашего кластера. Куда направить запрос дальше, внутри кластера, решают обычные Ingress-ресурсы, которые вы создаёте рядом со своими приложениями — без них запрос дойдёт до кластера и получит в ответ 404 от контроллера. То есть каждый домен настраивается в двух местах: в hosts кластера и в Ingress-ресурсе приложения. Минимальный пример такого ресурса:
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
name: my-app
spec:
ingressClassName: nginx
rules:
- host: app.<домен-пространства> # то же имя, что указано в hosts кластера
http:
paths:
- path: /
pathType: Prefix
backend:
service:
name: my-app # сервис вашего приложения
port:
number: 80
|
Flux CD позволяет хранить конфигурацию приложений в Git-репозитории: оператор сам скачивает манифесты и поддерживает состояние кластера в соответствии с репозиторием. Включайте, если работаете по GitOps-подходу. При использовании Argo CD или другого подобного инструмента Flux не включайте, иначе они будут спорить за управление одними и теми же ресурсами.
Velero сохраняет объекты Kubernetes в S3-совместимое хранилище и позволяет восстановиться после сбоя или ошибочного удаления. Настраивается фильтрами: копировать можно как весь кластер, так и отдельные пространства имён или типы объектов.
Образ операционной системы узлов (talos)
Рабочие узлы работают под управлением Talos Linux, и образ системы платформа скачивает по сети при создании каждого узла.
|
Параметр
|
Что делает
|
Значение по умолчанию
|
Когда менять
|
|
talos.imageFactoryURL
|
Адрес, откуда скачивается образ операционной системы узлов.
|
публичный репозиторий образов
|
Указывайте https://fs.oblakoteka.ru/talos — зеркало Облакотеки: публичный источник из сетей РФ доступен нестабильно, а без образа узлы не создадутся. Адрес пишется без косой черты на конце.
|
|
talos.version
|
Версия Talos Linux для узлов.
|
подставляется платформой
|
Не менять: версия согласована с выбранной версией Kubernetes.
|
|
talos.schematicID
|
Вариант сборки образа.
|
проверенная платформой сборка
|
Не менять без необходимости в собственной сборке образа.
|
|
talos.installerRepository
|
Источник образа-установщика для обновления узлов.
|
публичный репозиторий
|
Для изолированных сред и зеркал реестров.
|
Проверка здоровья узлов (nodeHealthCheck)
|
Параметр
|
Что делает
|
Значение по умолчанию
|
Когда менять
|
|
nodeHealthCheck.maxUnhealthy
|
Доля неисправных узлов в группе, при превышении которой платформа приостанавливает их автоматическую замену.
|
50%
|
Редко. Значение задавайте процентом.
|
|
nodeHealthCheck.nodeStartupTimeout
|
Сколько ждать готовности нового узла, прежде чем считать его неисправным и пересоздать.
|
10m
|
Увеличьте, если образ узла загружается медленно.
|
Вход пользователей в кластер (oidc)
|
Параметр
|
Что делает
|
Значение по умолчанию
|
Когда менять
|
|
oidc.mode
|
Способ входа: None — работает только kubeconfig из секрета, System — вход по учётным записям платформы без дополнительной настройки, CustomConfig — собственный провайдер входа.
|
None
|
System — чтобы дать коллегам доступ, не передавая им kubeconfig.
|
|
oidc.users
|
Кому открыт доступ при включённом входе: для каждого почта и роль — admin (полные права) или view (только просмотр).
|
[]
|
Вместе с mode: System.
|
|
oidc.customConfig
|
Описание собственного провайдера входа: конфигурация текстом или ссылка на существующий секрет.
|
пусто
|
Только при mode: CustomConfig, по согласованию с поддержкой.
|
Служебные
|
Параметр
|
Что делает
|
Значение по умолчанию
|
Когда менять
|
|
images.waitForKubeconfig / images.kubectl / images.talosCsrSigner
|
Переопределение служебных образов платформы — для изолированных сред и реестров с лимитами.
|
пусто = встроенные образы
|
Практически никогда, по указанию поддержки.
|
ПРИМЕР КОНФИГУРАЦИИ
Итоговая конфигурация, соответствующая шагам из руководства: два узла фиксированным размером и связка cert-manager + Ingress-NGINX. Остальные аддоны выключены, управляющий слой и служебные группы полей оставлены по умолчанию.
apiVersion: apps.cozystack.io/v1alpha1
kind: Kubernetes
metadata:
name: demo # имя кластера; адрес API будет kubernetes-demo.<домен-пространства>
spec:
version: v1.35 # версия из списка формы; при переезде — версия исходного кластера
host: "" # пусто = адрес по умолчанию
storageClass: replicated # класс хранения PVC приложений; неизменяемый после создания!
controlPlane:
replicas: 2 # 2 реплики управляющего слоя — отказоустойчивость
apiServer:
resources: {}
resourcesPreset: c1.medium
controllerManager:
resources: {}
resourcesPreset: t1.micro
scheduler:
resources: {}
resourcesPreset: t1.micro
konnectivity:
server:
resources: {}
resourcesPreset: t1.micro
talos:
imageFactoryURL: https://fs.oblakoteka.ru/talos # зеркало Облакотеки: публичный источник из сетей РФ нестабилен
nodeGroups:
md0:
minReplicas: 2 # ровно два узла:
maxReplicas: 2 # min = max отключает автомасштабирование
instanceType: u1.medium
diskSize: 20Gi # временный диск узла: образы, логи, временные данные
storageClass: "" # пусто = как у кластера; диски самих машин-узлов
roles:
- ingress-nginx # роль нужна для аддона Ingress-NGINX
resources: {}
gpus: []
kubelet: {}
addons:
certManager:
enabled: true # автоматические TLS-сертификаты
valuesOverride: {}
ingressNginx:
enabled: true # приём входящего HTTP/HTTPS-трафика
exposeMethod: Proxied
hosts: []
valuesOverride: {}
fluxcd:
enabled: false # GitOps-доставка манифестов
valuesOverride: {}
velero:
enabled: false # резервное копирование объектов кластера
valuesOverride: {}
cilium:
valuesOverride: {}
coredns:
valuesOverride: {}
gatewayAPI:
enabled: false
gpuOperator:
enabled: false
valuesOverride: {}
hami:
enabled: false
valuesOverride: {}
monitoringAgents:
enabled: false
valuesOverride: {}
ouroboros:
enabled: false
valuesOverride: {}
verticalPodAutoscaler:
valuesOverride: {}
|
ПРОВЕРКА
1. В дашборде: статус кластера — Ready, поды на вкладке Workloads — в состоянии Running, на вкладке Secrets доступен kubeconfig. На вкладке Ingresses должна появиться запись kubernetes-, адрес которой совпадает с адресом кластера в kubeconfig — это публикация API вашего кластера через входной шлюз платформы. Она создаётся вместе с управляющим слоем, и её наличие подтверждает, что он развёрнут и опубликован. Ingress-ресурсы ваших приложений появятся на этой вкладке позже, когда вы начнёте их публиковать.
2. Узлы зарегистрированы и готовы:
kubectl get nodes
|
Ожидаемый результат — все узлы в состоянии Ready (первые минуты после создания они могут быть NotReady, пока поднимается сеть). Имена узлов складываются из имени кластера, имени группы и случайных суффиксов, а колонка ROLES показывает роли группы:
NAME STATUS ROLES AGE VERSION
kubernetes-demo-md0-stxhx-4k6hh Ready ingress-nginx 5m v1.35.1
kubernetes-demo-md0-stxhx-7zq2m Ready ingress-nginx 5m v1.35.1
...
|
3. Системные компоненты запущены: kubectl get pods -A Все поды в состоянии Running или Completed. Если включали аддоны — в списке будут поды cert-manager, ingress-nginx, flux и velero.
ЧАСТЫЕ ОШИБКИ
Аддон Ingress-NGINX включён, всё в состоянии Running, но приложения снаружи недоступны — и нигде нет ни одной ошибки. Причина: способ публикации Proxied с пустым списком hosts. Входному шлюзу платформы некуда маршрутизировать трафик, маршрут для ваших доменов просто не создаётся, и это не считается ошибкой. Что делать: добавьте полные доменные имена приложений в ingressNginx.hosts и сохраните конфигурацию кластера.
Приложения перестали открываться, шлюз отвечает ошибкой 503. Причина: ни в одной группе узлов не осталось роли ingress-nginx — контроллеру входящего трафика негде работать, и запросы упираются в пустоту. Что делать: верните роль ingress-nginx хотя бы одной группе узлов.
Сразу после создания кластера узлы в состоянии NotReady. Причина: сеть кластера ещё запускается, а узлы становятся готовыми только после её старта — это нормальный порядок запуска, а не сбой. Что делать: подождите несколько минут. Если состояние не меняется 10–15 минут, посмотрите вкладку Events на странице кластера.
kubectl
не подключается: ошибки соединения или сертификатов. Причина: повреждён kubeconfig — скопирован не тот ключ секрета или при вставке сломалось форматирование YAML. Что делать: скопируйте содержимое ключа admin.conf кнопкой копирования и вставьте заново, проверив отступы.
Не удаётся изменить storageClass [кластера]{.underline}. Причина: этот параметр неизменяем после создания. Что делать: создайте новый кластер с нужным классом хранения и перенесите нагрузки.
Кластер в статусе Ready, но поды приложений висят в Pending. Причина: автомасштабирование упёрлось в maxReplicas, либо запросы ресурсов приложений не помещаются на узлы выбранного размера. Что делать: увеличьте maxReplicas группы узлов или выберите более крупный instanceType.
После переключения exposeMethod с Proxied на LoadBalancer приложения перестали открываться по прежним адресам. Причина: при LoadBalancer маршрут через общий шлюз платформы удаляется, а DNS-имена приложений всё ещё указывают на шлюз — тот отвечает 404. Что делать: направьте DNS-записи приложений на внешний адрес выделенного балансировщика, он виден на вкладке Services страницы кластера.
ЧТО ДАЛЬШЕ
Справочник по instanceType и resourcesPreset — какие типы инстансов и пресеты ресурсов доступны и как выбрать подходящий.